← 返回批注剪藏列表 / 人工智能与视觉
人工智能与视觉 ★ 读者评价
3D 点云目标检测核心机制
VoteNet 的 Deep Hough Voting 是如何产生的
深度剖析 ICCV 经典 3D 检测算法 VoteNet:从点云表面稀疏性痛点,到 Hough Voting 的 Ground Truth 标签生成、网络正向预测、聚类与损失函数全流程。
#3D点云
#目标检测
#VoteNet
#深度学习
#Hough投票
#PyTorch
#计算机视觉
#完整复刻
#深度批注
🎨 图例色彩导航:
原始算法思想与图解(灰白底)
几何数学与真值生成批注(琥珀金)
2026 现代 3D 目标检测演进(青蓝卡)
🟡 编者导读 · 3D 视觉几何的重大突破
在 2D 图像中,目标检测可以直接在密集像素网格上回归边界框;但在 3D 激光雷达与深度相机点云 中,物体表面点极其稀疏,且物体的 3D 几何中心往往处于空无一物的虚空中(例如桌子的中心、椅子的内部)。直接让网络从稀疏表面点回归虚空中心难度极大。
斯坦福大学 Charles R. Qi 与 Facebook AI Research 提出的 VoteNet 巧妙将经典霍夫投票(Hough Voting)转化为端到端可微的深度学习模块,彻底奠定了现代点云 3D 目标检测的基石。
📌 一、Hough Voting 的核心本质:为什么需要它?
在 PointNet++ 提取点云特征后,我们得到了一组位于物体表面的“种子点(Seed Points)” 与特征 。
- 痛点:3D 目标框的中心 往往远离任何表面点,位于空间虚空处。
- 解决之道(Hough Voting):训练一个多层感知机(MLP),让每个表面点预测一个指向物体中心的 3D 空间偏移向量 。
- 投票聚类:所有表面点加上各自的偏移量后,生成的“投票点(Vote Points)”将在物体中心自然交汇聚拢成致密的点簇,随后通过聚类网络(Proposal Module)即可精准预测 3D 边界框。
📐 二、Hough Voting 真实值(Ground Truth)的生成计算
在数据预处理阶段(如 votenet/sunrgbd/sunrgbd_data.py 或 scannet_data.py),我们需要为每个采样点生成监督信号:
1. 2D 简化直观图解
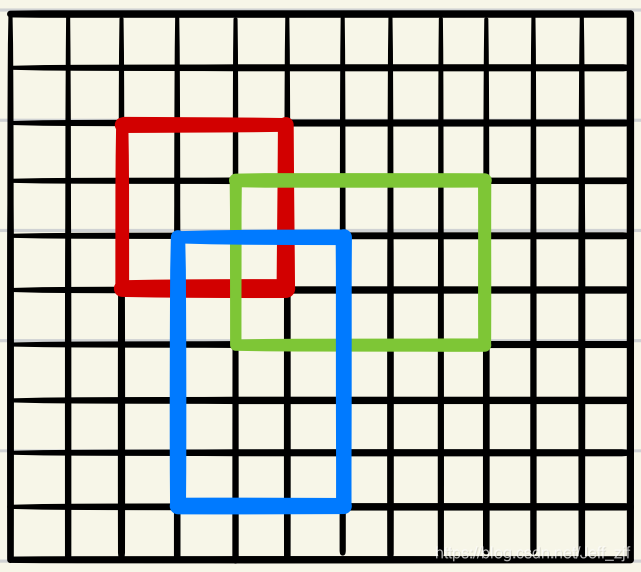
假设空间中有三个标注框(红、绿、蓝):
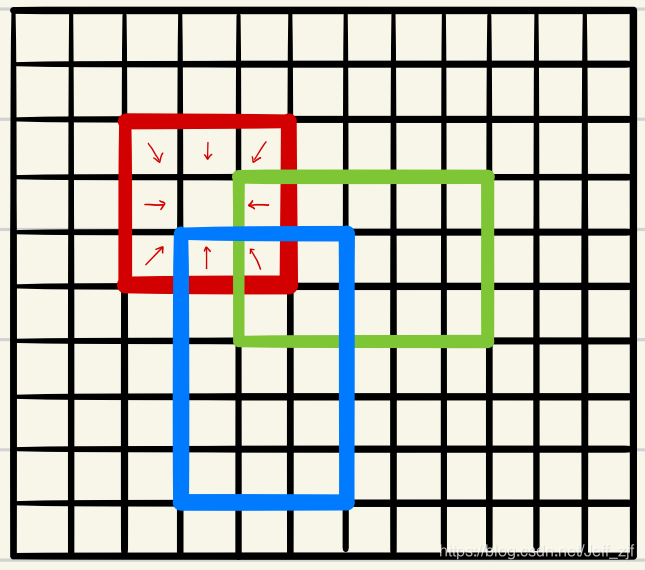
- Step 1(红色框投票):遍历处于红色框内部的所有点,计算每个点到红色框中心点的相对向量 :
- Step 2(绿色与蓝色框投票):同理计算绿色框与蓝色框内部所有点到各自中心的偏移向量:
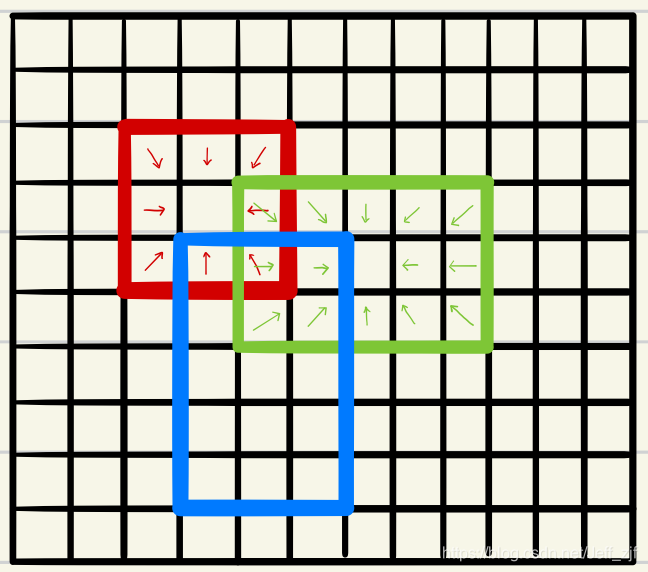
2. 核心数学表达与数据结构
在源码实现中,每个点 的真实投票标签定义如下:
\begin{cases} C_k - P_i, & \text{若 } P_i \text{ 位于目标框 } B_k \text{ 内部} \\ \mathbf{0}, & \text{若 } P_i \text{ 属于背景点} \end{cases}$$ 同时维护一个 **投票有效掩码(Vote Mask)**: $$\text{Mask}_i = \begin{cases} 1, & P_i \in \text{某个真实物体框} \\ 0, & P_i \in \text{背景点(不参与后续 Vote 损失计算)} \end{cases}$$ --- ## 🧠 三、网络前向传播(Forward Pass)中的投票预测 在模型 forward 阶段(`models/votenet.py`),Hough Voting 是通过一个轻量化的 **Voting Module** 学习实现的: ```mermaid flowchart LR A["原始点云 (N, 3)"] --> B["Backbone (PointNet++)"] B --> C["种子点 Seeds (M, 3) + 特征 (M, C)"] C --> D["Voting Module (Shared MLP)"] D --> E["预测偏移量 ΔP (M, 3)"] D --> F["特征偏移量 ΔF (M, C)"] C & E --> G["生成投票点 Votes: V = P + ΔP (M, 3)"] C & F --> H["聚合新特征: F' = F + ΔF (M, C)"] G & H --> I["Proposal Module (聚类与3D框生成)"] ``` ### 1. Voting Module 的代码实现逻辑 ```python import torch import torch.nn as nn class VotingModule(nn.Module): def __init__(self, in_dim, out_dim=3): super().__init__() self.in_dim = in_dim # 共享 MLP:通过特征学习空间几何偏移 self.mlp = nn.Sequential( nn.Conv1d(in_dim, in_dim, 1), nn.BatchNorm1d(in_dim), nn.ReLU(), nn.Conv1d(in_dim, in_dim, 1), nn.BatchNorm1d(in_dim), nn.ReLU(), nn.Conv1d(in_dim, (3 + in_dim), 1) # 输出 3D 坐标偏移 + 特征残差 ) def forward(self, seed_xyz, seed_features): """ seed_xyz: (B, 3, M) 种子点空间坐标 seed_features: (B, C, M) 种子点特征 """ net = self.mlp(seed_features) offset_xyz = net[:, :3, :] # 预测的偏移向量 ΔP offset_features = net[:, 3:, :] # 预测的特征更新 ΔF # 核心:将种子点移动到投票预测中心位置 vote_xyz = seed_xyz + offset_xyz vote_features = seed_features + offset_features return vote_xyz, vote_features ``` --- ## 🎯 四、损失函数:约束投票方向 为了让网络准确预测出真实的中心偏移量,VoteNet 使用了 **平滑 L1(Huber)损失** 来监督投票过程: $$\mathcal{L}_{\text{vote}} = \frac{1}{\sum_{i} \text{Mask}_i} \sum_{i=1}^{M} \text{Mask}_i \cdot \text{Smooth}_{L1} \left( \Delta P_i - \Delta P_i^* \right)$$ * **核心特性**:只有位于真实目标物体内部的点($\text{Mask}_i = 1$)才会计算投票误差,背景点完全不施加惩罚,从而让网络专注于学习物体内部的几何结构向心性。 --- ## 🚀 五、2026 现代 3D 目标检测演进前沿 <div class="box-expansion"> <div class="badge-expansion">🔵 2026 深度增补 · 现代 3D 检测架构跃迁</div> <div class="grid grid-cols-1 md:grid-cols-3 gap-3 my-4"> <div class="p-3 rounded-lg bg-white/70 dark:bg-slate-900/70 border border-cyan-200 dark:border-cyan-800"> <h4 class="font-bold text-slate-900 dark:text-white text-xs mb-1">1. 3DETR (Transformer 范式)</h4> <p class="text-base text-slate-600 dark:text-slate-400">抛弃手工聚类与 Hough Voting,利用可学习 Query 与全局自注意力实现端到端 3D 框直接预测。</p> </div> <div class="p-3 rounded-lg bg-white/70 dark:bg-slate-900/70 border border-cyan-200 dark:border-cyan-800"> <h4 class="font-bold text-slate-900 dark:text-white text-xs mb-1">2. CenterPoint (体素中心点检测)</h4> <p class="text-base text-slate-600 dark:text-slate-400">将 3D 点云栅格化为 2D 鸟瞰图(BEV),将 3D 目标直接看作关键热力点,成为自动驾驶领域的绝对工业标杆。</p> </div> <div class="p-3 rounded-lg bg-white/70 dark:bg-slate-900/70 border border-cyan-200 dark:border-cyan-800"> <h4 class="font-bold text-slate-900 dark:text-white text-xs mb-1">3. 多模态 3D 检测 (BEVFusion)</h4> <p class="text-base text-slate-600 dark:text-slate-400">将激光雷达点云与环视多相机图像在统一的统一 BEV 特征空间深度融合,兼顾丰富语义与精准几何深度。</p> </div> </div> </div> --- ## 📚 资料出处与致谢 - **原始讨论出处**:[CSDN 博客 · 《VoteNet 的 Hough voting 是怎么产生的》(作者:Z-Jeff)](https://blog.csdn.net/Jeff_zjf/article/details/106995206) - **学术原著论文**:Qi, Charles R., et al. *"Deep Hough Voting for 3D Object Detection in Point Clouds."* ICCV (2019) · [arXiv:1904.09664](https://arxiv.org/abs/1904.09664) - **官方开源代码**:[facebookresearch/votenet (GitHub)](https://github.com/facebookresearch/votenet) - **全量重构与 2026 演进**:Jenny Zhang · Jenny's Space(人工智能与视觉专栏) 🌟 读者学术评价与反馈 • PEER REVIEW & RATING
为本文打星评价
如果您觉得本文公式推导严谨、复现内容有启发,欢迎为文章打分支持!
0.0
☆☆☆☆☆
0 人已评价
👈 点击星星即可完成打分(1~5星)
✓ 已记录您的学术评价,感谢反馈!